


SEO & Technik
robots.txt und KI-Crawler: GPTBot, OAI-SearchBot und mehr
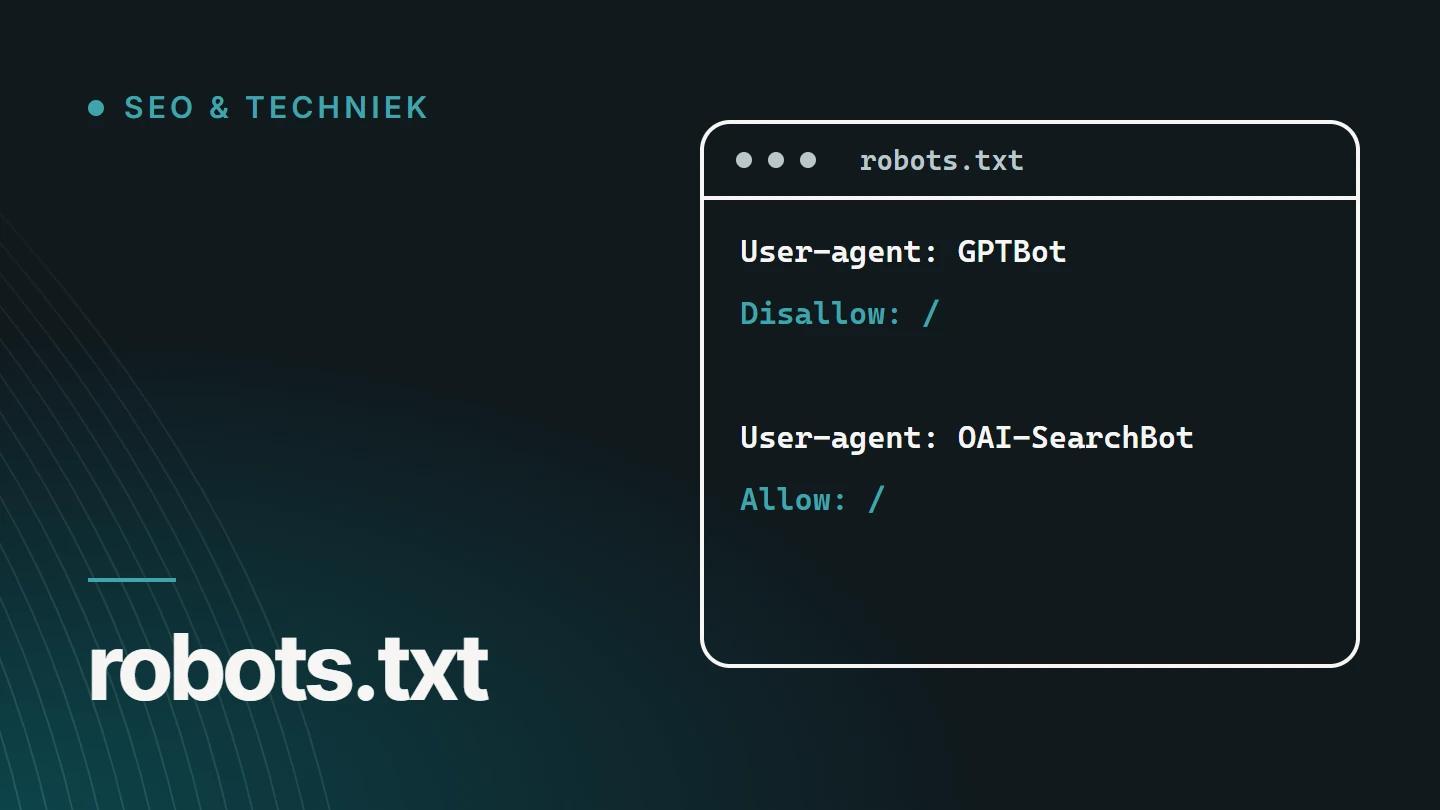
robots.txt ist eine Textdatei im Stammverzeichnis Ihrer Website, in der Sie Crawler bitten, bestimmte Bereiche abzurufen oder nicht. KI-Anbieter verwenden eigene Crawler mit eigenen Namen, etwa GPTBot und OAI-SearchBot, die Sie in dieser Datei einzeln zulassen oder ablehnen können. Es bleibt eine Bitte, kein Schloss.
Von Dries Nijs, Organic Web Specialist
Zuletzt aktualisiert: 19 November 2026
Auf einen Blick
robots.txt und KI-Crawler: die kurze Antwort
Die meisten KI-Anbieter arbeiten mit mehr als einem Crawler. Einer sammelt Inhalte, die zum Training von Modellen verwendet werden können, ein anderer baut den Suchindex auf, aus dem das System Quellen für seine Antworten bezieht, und ein dritter ruft eine Seite ab, wenn ein Nutzer selbst darum bittet.
Diese Unterscheidung ist wichtig, weil Sie die Crawler einzeln steuern können. Wer alle KI-Crawler auf einmal blockiert, schließt sich auch als Quelle in KI-Suchergebnissen aus. Wer nur das Training ablehnen möchte, kann das tun, ohne seine Sichtbarkeit aufzugeben.
Unten steht pro Anbieter, welche Namen offiziell dokumentiert sind, was sie tun und was robots.txt kann und was nicht. Die Angaben wurden am 17. November 2026 geprüft; Anbieter passen ihre Crawler regelmäßig an.
Grundlagen
Wie funktioniert robots.txt?
Die Datei liegt unter jouwdomein.be/robots.txt. Ein Crawler, der sich an die Vereinbarung hält, liest sie, bevor er Seiten abruft.
Die Regeln sind in einem formellen Internetstandard festgelegt, dem Robots Exclusion Protocol.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml- User-agent gibt an, für welchen Crawler die Regeln gelten. Ein Sternchen bedeutet: für alle.
- Disallow bittet darum, einen Pfad nicht abzurufen. Allow macht davon eine Ausnahme.
- Ein eigener Block hat Vorrang. Gibt es einen Block für einen bestimmten Crawler, folgt dieser Crawler diesem Block und nicht den allgemeinen Regeln.
- Sitemap verweist auf die Übersicht Ihrer indexierbaren Seiten.
Unterscheidung
Drei Arten von KI-Crawlern
Der Name eines Crawlers sagt wenig aus. Entscheidend ist, wofür die abgerufenen Inhalte verwendet werden.
Für das Modell
Trainings-Crawler
Sie sammeln öffentliche Inhalte, die zum Training künftiger Modelle verwendet werden können. Sie abzulehnen hat keinen Einfluss auf Ihre Platzierung in Suchergebnissen.
Für die Antworten
Such-Crawler
Sie bauen den Index auf, aus dem ein KI-System Quellen auswählt und Links anzeigt. Wer sie ablehnt, erscheint dort nicht oder kaum als Quelle.
Auf Anfrage
Abrufe durch Nutzer
Jemand fügt einen Link ein oder bittet das System, sich eine Seite anzusehen. Das ist kein automatisches Crawlen, und Anbieter behandeln es anders als ihre Crawler.
Referenz
Welche KI-Crawler sind offiziell dokumentiert?
Diese Übersicht enthält nur Namen, die der Anbieter selbst beschreibt. In Ihren Serverlogs tauchen auch andere Bots auf; ohne offizielle Dokumentation wissen Sie nicht sicher, von wem sie stammen oder was sie tun.
| Name in robots.txt | Anbieter | Art | Was der Anbieter dazu sagt |
|---|---|---|---|
GPTBot | OpenAI | Training | Ruft Inhalte ab, die zum Training der Modelle von OpenAI verwendet werden können. |
OAI-SearchBot | OpenAI | Suchen | Dient der Suchfunktion von ChatGPT. Unabhängig von GPTBot: Sie können das eine zulassen und das andere ablehnen. |
ChatGPT-User | OpenAI | Auf Anfrage eines Nutzers | Besucht eine Seite, wenn ein Nutzer darum bittet. Kein automatischer Crawler; robots.txt-Regeln gelten hier möglicherweise nicht. |
OAI-AdsBot | OpenAI | Werbung | Prüft Seiten, die als Anzeige in ChatGPT eingereicht wurden. Besucht laut OpenAI nur diese Seiten; die Daten dienen nicht dem Training von Modellen. |
ClaudeBot | Anthropic | Training | Sammelt öffentliche Webinhalte, die zum Training von Modellen beitragen können. Befolgt robots.txt. |
Claude-SearchBot | Anthropic | Suchen | Indexiert Inhalte, um die Qualität der Suchergebnisse für Nutzer zu verbessern. |
Claude-User | Anthropic | Auf Anfrage eines Nutzers | Ruft Seiten ab, wenn ein Nutzer von Claude eine Frage stellt, die das erfordert. Befolgt laut Anthropic robots.txt. |
PerplexityBot | Perplexity | Suchen | Dient dazu, Websites in den Suchergebnissen von Perplexity anzuzeigen und zu verlinken; laut Perplexity nicht zum Training von Basismodellen. |
Perplexity-User | Perplexity | Auf Anfrage eines Nutzers | Besucht eine Seite, wenn die Frage eines Nutzers das erfordert; ignoriert dabei in der Regel robots.txt. |
Google-Extended | Token, kein Crawler | Regelt, ob Inhalte, die Google bereits crawlt, zum Training von Gemini-Modellen und für Grounding verwendet werden dürfen. Hat keinen Einfluss auf die Google Suche. | |
Applebot-Extended | Apple | Token, kein Crawler | Regelt, ob Inhalte, die Applebot abruft, zum Training der generativen Modelle von Apple verwendet werden dürfen. Suchergebnisse bleiben möglich. |
CCBot | Common Crawl | Offenes Webarchiv | Baut ein offenes, öffentlich zugängliches Archiv von Webdaten auf. Prüft laut Common Crawl zuerst robots.txt. |
Zuletzt geprüft: 17. November 2026. Jeder Name in der Tabelle wurde an diesem Datum in der Dokumentation des jeweiligen Anbieters selbst gefunden. Die Liste ist nicht vollständig: Anbieter beschreiben auch andere, spezialisiertere Agents.
Quellen: die Dokumentation von OpenAI, Anthropic, Perplexity, Google, Apple und Common Crawl, abgerufen am 17. November 2026. Lesen Sie im Zweifel immer die Seite des Anbieters selbst: Sie ist maßgeblich.
Und was ist mit Google AI Overviews und AI Mode?
Sie gehören zur Google Suche und verwenden den normalen Googlebot. Es gibt keinen eigenen Crawler, den Sie für AI Overviews ablehnen können. Google-Extended ändert daran nichts: Dieses Token betrifft das Training von Gemini-Modellen und Grounding, nicht die Suchergebnisse.
Wer nicht in den KI-Funktionen der Google Suche erscheinen möchte, landet also bei den Einstellungen, die auch für normale Suchergebnisse gelten, etwa Einschränkungen für Snippets. Das wirkt sich sofort darauf aus, wie Sie in den klassischen Ergebnissen angezeigt werden. Für die meisten Unternehmenswebsites ist das kein lohnender Tausch. Mehr dazu im Artikel Wie kommen Sie in die Google AI Overviews?.
Beispiel
Suche zulassen und Training ablehnen: Wie sieht das aus?
Das ist eine mögliche Entscheidung, keine Empfehlung für jede Website. Jeder Block gilt für einen Crawler.
Google-Extended und Applebot-Extended können Sie auf dieselbe Weise mit einem eigenen Block versehen. Achtung: Laut Google regelt Google-Extended auch Grounding, also die Nutzung Ihrer Inhalte als Quelle in Gemini.
# Zoekcrawlers van AI-systemen: toegelaten
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Trainingscrawlers: geweigerd
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /
Gibt es in Ihrer Datei keinen Block für einen bestimmten Crawler, folgt dieser den allgemeinen Regeln unter User-agent: *. Ein KI-Crawler, den Sie nirgends nennen, darf also alles, was andere Crawler dürfen.
Entscheiden
KI-Crawler zulassen oder blockieren?
Es gibt keine richtige Antwort für alle. Es hängt davon ab, was Ihre Website leisten soll.
Such-Crawler zuzulassen liegt nahe, wenn
- Sie von Menschen gefunden werden möchten, die ein KI-System um Rat fragen
- Ihre Website Ihre Leistungen oder Produkte vorstellt
- Sie möchten, dass ein System Ihre eigenen Seiten als Quelle nutzt und nicht nur das, was andere über Sie schreiben
Training abzulehnen kann sinnvoll sein, wenn
- Ihre Inhalte selbst das Produkt sind, etwa kostenpflichtige Artikel oder Kurse
- Sie aus Prinzip nicht zum Training von Modellen beitragen möchten
- Sie rechtliche oder vertragliche Gründe haben, die Weiterverwendung einzuschränken
Für eine Unternehmenswebsite ist das Blockieren von Such-Crawlern selten von Vorteil: Sie verschwinden als Quelle, während das System auf Basis anderer Websites weiterhin über Sie sprechen kann. Was Sie mit Trainings-Crawlern machen, entscheiden Sie selbst.
Grenzen
Was robots.txt nicht kann
- Nichts erzwingen. Die Datei ist eine Bitte. Crawler bekannter Anbieter geben an, sie zu befolgen; ein Bot mit schlechten Absichten liest sie nicht.
- Nichts absichern. Was nicht öffentlich sein darf, gehört hinter einen Login. Eine Disallow-Regel verrät höchstens, wo es liegt.
- Keine Abrufe durch Nutzer verhindern. Mehrere Anbieter behandeln einen Besuch auf Anfrage eines Nutzers anders als automatisches Crawlen.
- Nichts rückgängig machen. Eine Regel von heute entfernt keine Inhalte, die bereits früher abgerufen wurden.
- Nicht aus dem Index heraushalten. Disallow verhindert das Abrufen, nicht das Indexieren einer URL. Dafür dient noindex. Siehe Website oder Seite nicht indexiert?.
Wer echte Kontrolle möchte, braucht mehr als robots.txt: Zugriffskontrolle auf dem Server oder Firewall-Regeln auf Basis der IP-Bereiche, die Anbieter veröffentlichen.
Kontrolle
Wie prüfen Sie, was Ihre Website zulässt?
Viele Websites blockieren KI-Crawler, ohne dass der Betreiber es weiß, oder lassen alles zu, ohne dass das je entschieden wurde. So prüfen Sie es.
01
Öffnen Sie Ihre robots.txt
Geben Sie Ihre Domain gefolgt von /robots.txt ein. Lesen Sie zuerst die allgemeinen Regeln, dann die Blöcke pro Crawler.
02
Suchen Sie nach einer zu weit gefassten Regel
Ein Disallow: / unter User-agent: * schließt alle aus, auch Suchmaschinen. Das passiert nach einem Go-live häufiger, als man denkt.
03
Schauen Sie über die Datei hinaus
Hosting, ein CDN oder ein Sicherheits-Plugin kann Bots blockieren, bevor sie Ihre robots.txt lesen. Prüfen Sie auch diese Einstellungen.
04
Sehen Sie sich Ihre Serverlogs an
Dort sehen Sie, welche Crawler tatsächlich vorbeikommen und welche Antwort sie erhalten.
05
Halten Sie Ihre Entscheidung fest
Entscheiden Sie pro Crawler-Art, was Sie möchten, und notieren Sie, warum. So bleibt die Datei kein zufälliges Überbleibsel.
06
Prüfen Sie sie regelmäßig
Anbieter fügen Crawler hinzu und ändern ihr Verhalten. Es kann auch eine Weile dauern, bis eine Anpassung überall umgesetzt ist.
Entwicklung
Was ändert sich noch?
Das Feld ist noch in Bewegung. 2026 haben mehrere Anbieter angekündigt, ein gemeinsames Signal für KI-Training in robots.txt unterstützen zu wollen, damit Sie Ihre Präferenz nicht mehr für jeden Crawler einzeln wiederholen müssen. Die Einführung unterscheidet sich je nach Anbieter, und die bestehenden Namen funktionieren weiterhin.
Daneben gibt es Vorschläge wie llms.txt, das keinen Zugriff regelt, sondern eine Übersicht Ihrer Inhalte bereitstellt. Was das leistet und was nicht, lesen Sie im Artikel llms.txt: was die Datei leistet – und was nicht.
Robots.txt ist dabei nur ein Teil der Crawlbarkeit. Rendering, Statuscodes, Canonicals und interne Links bestimmen mit, ob ein Crawler Ihre Inhalte auch wirklich lesen kann. Das alles fällt unter technische SEO.
FAQ
Häufige Fragen zu robots.txt und KI-Crawlern
Ist eine robots.txt-Datei nötig?
Sie ist keine Pflicht. Ohne Datei gehen Crawler davon aus, dass alles abgerufen werden darf. Eine robots.txt ist aber nützlich, um Bereiche wie den Verwaltungsbereich oder interne Suchergebnisse auszuschließen und auf Ihre Sitemap zu verweisen.
Wo finde ich die robots.txt-Datei meiner Website?
Immer im Stammverzeichnis: Ihr Domainname gefolgt von /robots.txt. Liegt sie woanders, lesen Crawler sie nicht.
Wie passe ich die robots.txt in WordPress an?
WordPress erstellt selbst eine virtuelle robots.txt-Datei, wenn keine echte Datei vorhanden ist. Anpassen können Sie sie mit einem SEO-Plugin, das einen Editor für die Datei bietet, oder indem Sie eine eigene Datei im Stammverzeichnis ablegen. Prüfen Sie danach im Browser, was tatsächlich ausgeliefert wird.
Wenn ich GPTBot blockiere, verschwinde ich dann aus ChatGPT?
Nicht allein durch diese Regel. Laut OpenAI steht GPTBot für das Training und OAI-SearchBot für die Suchfunktion von ChatGPT, und die Einstellungen sind voneinander unabhängig. Sie können GPTBot also ablehnen und OAI-SearchBot zulassen.
Funktioniert robots.txt noch?
Ja, für Crawler, die sich daran halten, und dazu gehören unter anderem die dokumentierten Crawler der großen Suchmaschinen und KI-Anbieter. Es ist keine technische Sperre: Wer die Vereinbarung ignorieren will, kann das.
Ist es illegal, robots.txt zu ignorieren?
Robots.txt ist eine technische Vereinbarung, kein Gesetz. Ob ihre Missachtung rechtliche Folgen hat, hängt vom Land, den Nutzungsbedingungen und dem Urheberrecht ab. Das ist eine Frage für einen Juristen, nicht für einen Entwickler.
Mehr zu diesem Thema
Weiterlesen
Die passende Dienstleistung
Technische SEO als Dienstleistung
Sind Sie unsicher, ob Suchmaschinen und KI-Crawler Ihre Website abrufen und lesen können? Auf der Leistungsseite steht, wie ich Crawlbarkeit, Rendering und Indexierung untersuche und Probleme behebe.

Über den Autor
Dries Nijs, Organic Web Specialist
Ich bin Dries Nijs, Entwickler und SEO-Berater aus Maasmechelen. Crawlbarkeit prüfe ich im Code, in den Servereinstellungen und in den Logs, nicht nur in einem Tool. MadeByDries ist die persönliche Marke, unter der ich arbeite.
Wissen Sie, welche Crawler Ihre Website zulässt?
Erzählen Sie mir von Ihrer Website. Dann prüfen wir, was Suchmaschinen und KI-Crawler heute davon lesen können.