


AI & Automation
AI met bedrijfsdata: API, RAG en privacy uitgelegd
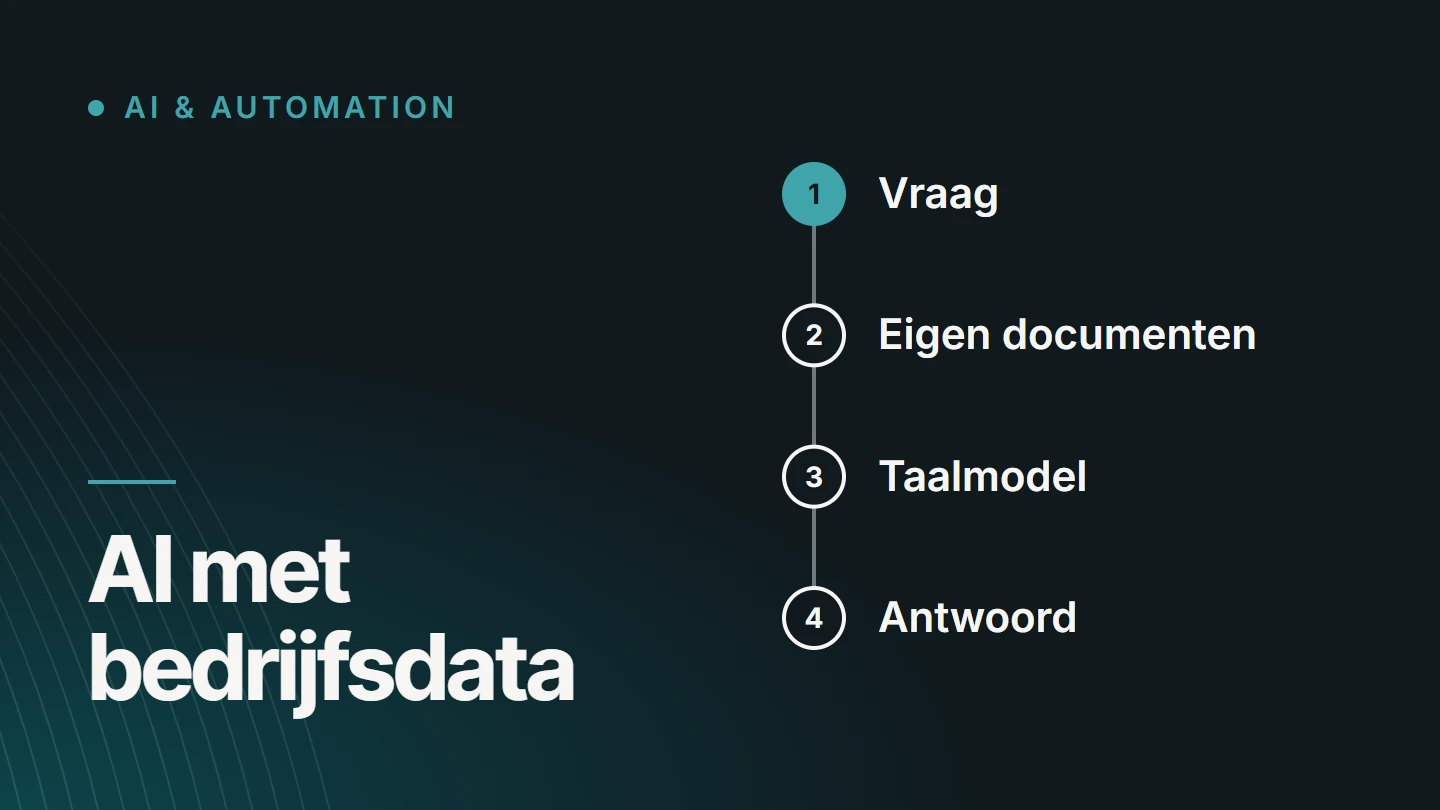
AI met bedrijfsdata betekent dat een taalmodel antwoordt op basis van je eigen documenten en gegevens, die je software bij elke vraag opzoekt en via een API meestuurt. Het model zelf kent je bedrijf niet: het werd getraind op algemene teksten en weet niets van je klanten, prijzen of procedures. De techniek van eerst opzoeken en dan laten antwoorden heet RAG, retrieval-augmented generation.
Door Dries Nijs, Organic Web Specialist
Laatst bijgewerkt: 17 november 2026
In het kort
Hoe werkt AI met bedrijfsdata? Het korte antwoord
Voor een bruikbaar antwoord over je bedrijf zijn twee soorten kennis nodig. Modelkennis is wat het taalmodel tijdens zijn training leerde: taal, algemene feiten, redeneren. Bedrijfskennis is wat alleen in jouw systemen staat. Die tweede soort zit niet in het model, en hoeft er ook niet in.
In plaats van het model opnieuw te trainen, geef je het de juiste informatie op het juiste moment. Je software zoekt de passages op die bij de vraag horen, stuurt ze mee en vraagt het model om alleen daarop te steunen. Je documenten blijven staan waar ze staan; alleen wat voor die ene vraag nodig is, gaat naar het model.
Daardoor worden drie dingen belangrijker dan het model zelf: de kwaliteit van je documenten, de toegangsrechten bij het opzoeken en de afspraken met de aanbieder over wat er met de meegestuurde gegevens gebeurt.
Vergelijking
Modelkennis en bedrijfskennis: wat is het verschil?
Een taalmodel klinkt alsof het alles weet. Toch komt wat het zegt uit twee duidelijk verschillende bronnen.
| Kenmerk | Modelkennis | Bedrijfskennis |
|---|---|---|
| Herkomst | De teksten waarop het model getraind is | Je eigen documenten, databanken en systemen |
| Inhoud | Taal, algemene kennis, redeneren | Producten, prijzen, klanten, procedures, afspraken |
| Actualiteit | Loopt tot het moment waarop de training stopte | Zo actueel als je eigen bronnen |
| Bijwerken | Pas bij een nieuwe versie van het model | Je past het document aan en het antwoord verandert mee |
| Bron aanwijzen | Niet mogelijk | Het antwoord kan naar het brondocument verwijzen |
| Toegang | Gelijk voor iedereen die het model gebruikt | Afhankelijk van wie de vraag stelt |
Krijgt een model een vraag over je bedrijf zonder dat het bedrijfskennis meekreeg, dan vult het de leemte op met iets wat plausibel klinkt. Zo’n verzonnen antwoord heet een hallucinatie. De oplossing is niet een slimmer model, maar de juiste informatie bij de vraag.
Koppeling
De API: hoe je software met het model praat
Je software praat met een taalmodel via een API: ze stuurt een verzoek met een instructie en de nodige tekst, en krijgt een antwoord terug. Alles wat het model voor dat antwoord mag gebruiken, zit in dat ene verzoek.
Twee eigenschappen bepalen hoe je met bedrijfsdata omgaat. Het model onthoudt zelf niets tussen twee aanroepen: wat je de vorige keer meestuurde, is weg. En er is een grens aan de hoeveelheid tekst per aanroep, dus je volledige archief meesturen kan niet. Meer tekst maakt het antwoord bovendien niet vanzelf beter.
Daaruit volgt de kernvraag van dit onderwerp: welke stukken informatie stuur je mee bij welke vraag? Het antwoord daarop is retrieval, het opzoeken van de juiste passages. Hoe zo’n koppeling in bestaande software past, staat in AI-integraties: AI koppelen aan bestaande systemen.
Techniek
Hoe werkt RAG (retrieval-augmented generation)?
RAG staat voor retrieval-augmented generation: eerst opzoeken (retrieval), dan het model laten antwoorden (generation) met de gevonden tekst als aanvulling (augmented). In zes stappen:
01
Documenten voorbereiden
Je bronnen worden opgesplitst in kleinere stukken, zoals een alinea of een hoofdstuk, zodat er later gericht in gezocht kan worden.
02
Indexeren
Van elk stuk wordt een embedding berekend: een reeks getallen die de betekenis van de tekst weergeeft. Die reeksen worden bewaard in een index, vaak een vectordatabank.
03
Opzoeken
Een vraag wordt op dezelfde manier omgezet en vergeleken met de index. De stukken waarvan de betekenis het dichtst bij de vraag ligt, komen bovenaan, ook wanneer ze andere woorden gebruiken. Vaak wordt dat gecombineerd met zoeken op trefwoorden.
04
Aanvullen
De gevonden stukken gaan samen met de vraag en een instructie naar het model: antwoord alleen op basis van deze tekst, en zeg het wanneer het antwoord er niet in staat.
05
Antwoorden
Het model formuleert een antwoord uit de aangeleverde passages. Het zoekt zelf niets op: het leest wat de zoekstap aanleverde.
06
Verwijzen naar de bron
Bij het antwoord staat uit welk document het komt, zodat een medewerker het kan nalezen.
Bronnen
Welke documenten en data zijn geschikt?
Een antwoord uit RAG is nooit beter dan de bron waaruit het komt. Wat in je documenten fout, verouderd of tegenstrijdig is, komt ook zo in het antwoord terecht.
Goed bruikbaar
- handleidingen, procedures en werkinstructies
- productinformatie en technische fiches
- veelgestelde vragen met een nagekeken antwoord
- voorwaarden en beleidsteksten in hun huidige versie
- documenten met een duidelijke titel, datum en eigenaar
Eerst op orde brengen
- oude versies die naast de huidige blijven staan
- documenten die elkaar tegenspreken
- scans en afbeeldingen zonder leesbare tekst
- kennis die alleen in hoofden of mailboxen zit
- bestanden waarvan niemand weet of ze nog kloppen
Gestructureerde gegevens, zoals bestellingen, voorraad of klantenfiches, zoek je beter rechtstreeks op in de databank dan via tekstpassages. Een goede oplossing combineert vaak beide: passages uit documenten voor uitleg, een gerichte opvraging voor cijfers en statussen. Mag het model zulke opvragingen zelf kiezen en uitvoeren, dan spreek je van een agent: zie AI-agents voor bedrijven: 7 processen die je kunt automatiseren.
Afspraken
Toegangsrechten, privacy en beveiliging
Zodra een model met bedrijfsdata werkt, gaat het niet meer alleen om de kwaliteit van het antwoord, maar ook om wie wat te zien krijgt en waar de gegevens terechtkomen.
- Rechten bij het opzoeken De zoekstap geeft alleen documenten terug die de vraagsteller zelf mag inzien. Die controle gebeurt in je software, voor er iets naar het model gaat, en niet door het model.
- Zo weinig mogelijk meesturen Alleen de passages die de vraag vereist, gaan mee. Wat niet nodig is, zoals namen of contactgegevens, laat je weg of maak je onherkenbaar.
- Wat je systemen verlaat Breng in kaart welke gegevens naar de aanbieder van het model gaan, en of er persoonsgegevens of vertrouwelijke informatie tussen zitten.
- Waar het verwerkt wordt Ga na in welke regio de gegevens verwerkt worden en hoelang de aanbieder ze bewaart.
- Gebruik voor training Lees in de voorwaarden van de aanbieder of meegestuurde gegevens gebruikt worden om modellen te trainen, en of je dat kunt uitsluiten.
- Sleutels en index De sleutel van de API blijft op de server. Ook de index bevat je bedrijfsinformatie en verdient dezelfde beveiliging als de documenten zelf.
Bevatten de documenten persoonsgegevens, dan is de AVG het kader waarbinnen je dat alles afweegt. Dit is geen juridisch advies: laat je concrete situatie nakijken door iemand met kennis van privacyrecht.
Grenzen
Waarom je bedrijfsdata niet zomaar in een model stopt
Plakken in een publieke chatdienst
Wie een contract of een klantenlijst in een publieke chatdienst plakt, stuurt die gegevens naar een externe partij zonder dat je bedrijf daar afspraken over maakte. Leg daarom intern vast welke gegevens in welke tools mogen, en voorzie een alternatief dat wel onder je eigen afspraken valt.
Een model trainen op je eigen data
Een model bijtrainen, ook finetunen genoemd, past vooral zijn stijl of gedrag aan. Als opslagplaats voor kennis is het minder geschikt: je kunt een feit er niet gericht uit verwijderen of in bijwerken, het model kan niet aanwijzen waar een antwoord vandaan komt, en het maakt geen onderscheid naargelang wie de vraag stelt. Voor kennis die verandert of niet voor iedereen bestemd is, is opzoeken op het moment van de vraag de logischere weg.
Menselijke controle blijft nodig
Ook met de juiste passages erbij kan een model iets verkeerd lezen of twee bronnen fout combineren. Laat een persoon antwoorden nakijken, goedkeuren of verbeteren waar een fout gevolgen heeft, en toon altijd de bron. Hoe ik automatisering en AI-koppelingen voor bedrijven aanpak, lees je op de pagina AI-automatisering.
FAQ
Veelgestelde vragen over AI met bedrijfsdata
Wat is RAG in eenvoudige woorden?
RAG is een openboekexamen voor een taalmodel. In plaats van uit het hoofd te antwoorden, krijgt het model bij elke vraag de passages uit je eigen documenten die erbij horen, en formuleert het daaruit een antwoord. De afkorting staat voor retrieval-augmented generation.
Moet ik een model trainen op mijn eigen data?
Voor kennis meestal niet. Opzoeken op het moment van de vraag houdt je informatie actueel, respecteert toegangsrechten en laat toe om de bron te tonen. Bijtrainen is eerder iets voor een vaste stijl of een heel specifieke taak.
Kent een taalmodel mijn bedrijf?
Hoogstens wat er publiek over te lezen was toen het model getraind werd, en ook dat is onvolledig en niet actueel. Interne documenten, prijzen, klanten en afspraken kent het niet, tenzij je ze bij de vraag meestuurt.
Kan AI met bedrijfsdata nog fouten maken?
Ja. RAG verkleint de kans dat het model iets verzint, omdat het antwoord op aangeleverde tekst steunt, maar sluit fouten niet uit. De zoekstap kan de verkeerde passage vinden, of het model kan een passage verkeerd lezen. Een bronvermelding en een mens die naleest waar het ertoe doet, blijven nodig.
Is RAG veilig voor vertrouwelijke documenten?
Dat hangt af van de opzet. Bepalend zijn de toegangsrechten bij het opzoeken, de plaats waar de index en de documenten staan en de voorwaarden van de aanbieder van het model. Voor zeer gevoelige gegevens kan een model op eigen infrastructuur een optie zijn.
Heb ik een vectordatabank nodig?
Niet altijd. Voor een beperkte set documenten kan een gewone zoekfunctie of een uitbreiding van je bestaande databank volstaan. Een aparte vectordatabank wordt zinvol bij grote hoeveelheden tekst of wanneer zoeken op betekenis duidelijk betere resultaten geeft.
Is AI met bedrijfsdata haalbaar voor een KMO?
De techniek is niet voorbehouden aan grote bedrijven. Wat het werk bepaalt, is de staat van je documenten, het aantal bronnen en de eisen rond toegang. Een afgebakende start, zoals één set handleidingen voor één team, houdt het overzichtelijk. Voor maatwerk geldt prijs op aanvraag.
Meer over dit onderwerp
Verder lezen
De dienst bij dit onderwerp
AI-automatisering als dienst
Wil je een taalmodel laten werken met je eigen documenten of systemen? Op de dienstpagina staat hoe ik automatisering en AI-koppelingen aanpak, met aandacht voor gegevens, rechten en controle.

Over de auteur
Dries Nijs, Organic Web Specialist
Ik ben Dries Nijs, developer uit Maasmechelen. Ik bouw sinds de jaren 90 voor het web: webapplicaties in React, Next.js en Node.js en websites in WordPress. In mijn eigen platformen, zoals BM Jumpfun, Pelletkachelzorg en SEO Websites, gebruik ik AI via API’s. MadeByDries is het persoonlijke merk waaronder ik werk.
AI laten werken met je eigen gegevens?
Vertel me welke vragen het systeem moet beantwoorden en waar de informatie vandaag staat. Dan bekijk ik met je wat haalbaar en verantwoord is.