


SEO & technique
robots.txt et robots IA : GPTBot, OAI-SearchBot et autres
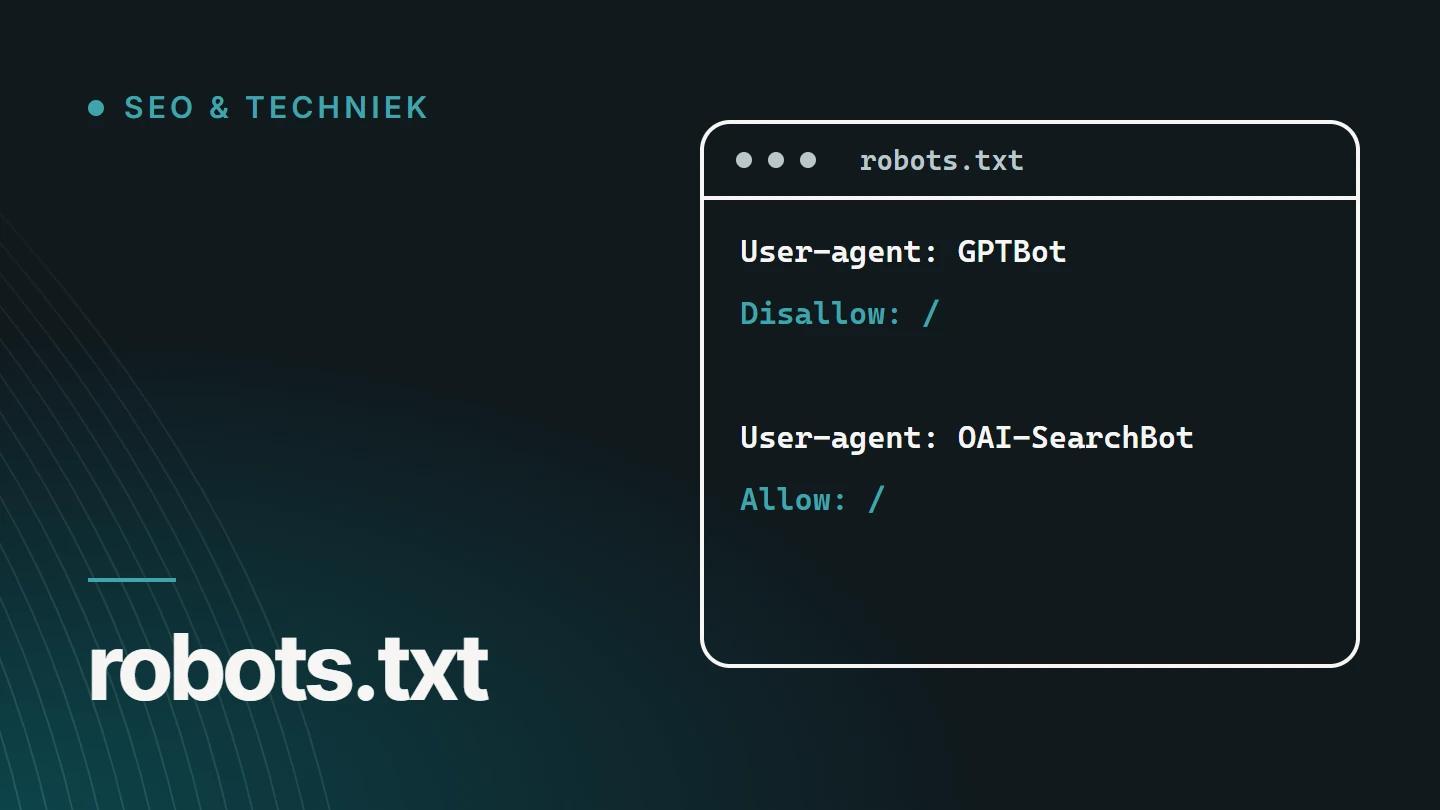
robots.txt est un fichier texte placé à la racine de votre site, dans lequel vous demandez aux robots d’exploration de récupérer ou non certaines parties. Les fournisseurs d’IA utilisent leurs propres robots, avec leurs propres noms, comme GPTBot et OAI-SearchBot, que vous pouvez autoriser ou refuser séparément dans ce fichier. Cela reste une demande, pas un verrou.
Par Dries Nijs, spécialiste Organic Web
Dernière mise à jour : 19 novembre 2026
En bref
robots.txt et robots d’IA : la réponse courte
La plupart des fournisseurs d’IA utilisent plus d’un robot. L’un collecte du contenu qui peut servir à entraîner des modèles, un autre construit l’index de recherche dans lequel le système puise les sources de ses réponses, et un troisième récupère une page quand un utilisateur le demande lui-même.
Cette distinction est importante, car vous pouvez les gérer séparément. Celui qui bloque tous les robots d’IA d’un seul coup s’exclut aussi comme source dans les résultats de recherche IA. Celui qui veut seulement refuser l’entraînement peut le faire sans renoncer à sa visibilité.
Vous trouverez ci-dessous, par fournisseur, les noms officiellement documentés, ce qu’ils font et ce que robots.txt peut et ne peut pas faire. Les informations ont été vérifiées le 17 novembre 2026 ; les fournisseurs modifient régulièrement leurs robots.
Les bases
Comment fonctionne robots.txt ?
Le fichier se trouve à l’adresse jouwdomein.be/robots.txt. Un robot qui respecte la convention le lit avant de récupérer des pages.
Les règles sont fixées dans une norme Internet formelle, le Robots Exclusion Protocol.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml- User-agent indique à quel robot les règles s’appliquent. Un astérisque signifie : à tous.
- Disallow demande de ne pas récupérer un chemin. Allow y fait une exception.
- Un bloc spécifique l’emporte. S’il existe un bloc pour un robot précis, ce robot suit ce bloc et non les règles générales.
- Sitemap renvoie vers la liste de vos pages indexables.
Distinction
Trois types de robots d’IA
Le nom d’un robot dit peu de chose. Ce qui compte, c’est l’usage du contenu récupéré.
Pour le modèle
Robots d’entraînement
Ils collectent du contenu public qui peut servir à entraîner de futurs modèles. Les refuser n’a aucune influence sur votre place dans les résultats de recherche.
Pour les réponses
Robots de recherche
Ils construisent l’index dans lequel un système d’IA choisit ses sources et affiche des liens. Celui qui les refuse n’y apparaît pas, ou à peine, comme source.
À la demande
Récupérations par les utilisateurs
Quelqu’un colle un lien ou demande au système de consulter une page. Il ne s’agit pas d’une exploration automatique, et les fournisseurs la traitent différemment de leurs robots.
Référence
Quels robots d’IA sont officiellement documentés ?
Cet aperçu ne contient que des noms que le fournisseur décrit lui-même. D’autres bots apparaissent aussi dans vos journaux de serveur ; sans documentation officielle, vous ne savez pas avec certitude à qui ils appartiennent ni ce qu’ils font.
| Nom dans robots.txt | Fournisseur | Type | Ce qu’en dit le fournisseur |
|---|---|---|---|
GPTBot | OpenAI | Entraînement | Récupère du contenu qui peut servir à entraîner les modèles d’OpenAI. |
OAI-SearchBot | OpenAI | Rechercher | Sert à la fonction de recherche de ChatGPT. Indépendant de GPTBot : vous pouvez autoriser l’un et refuser l’autre. |
ChatGPT-User | OpenAI | À la demande d’un utilisateur | Visite une page lorsqu’un utilisateur le demande. Pas un robot automatique ; les règles de robots.txt ne s’appliquent peut-être pas ici. |
OAI-AdsBot | OpenAI | Publicités | Contrôle les pages soumises comme publicité dans ChatGPT. Selon OpenAI, il ne visite que ces pages ; les données ne servent pas à entraîner des modèles. |
ClaudeBot | Anthropic | Entraînement | Collecte du contenu web public qui peut contribuer à l’entraînement de modèles. Respecte robots.txt. |
Claude-SearchBot | Anthropic | Rechercher | Indexe du contenu pour améliorer la qualité des résultats de recherche pour les utilisateurs. |
Claude-User | Anthropic | À la demande d’un utilisateur | Récupère des pages lorsqu’un utilisateur de Claude pose une question qui le nécessite. Selon Anthropic, respecte robots.txt. |
PerplexityBot | Perplexity | Rechercher | Sert à afficher et à lier des sites dans les résultats de recherche de Perplexity ; selon Perplexity, pas à entraîner des modèles de base. |
Perplexity-User | Perplexity | À la demande d’un utilisateur | Visite une page lorsque la question d’un utilisateur le nécessite ; ignore généralement robots.txt dans ce cas. |
Google-Extended | Jeton, pas un robot | Détermine si le contenu que Google explore déjà peut servir à entraîner les modèles Gemini et à l’ancrage (grounding). N’a aucune influence sur la recherche Google. | |
Applebot-Extended | Apple | Jeton, pas un robot | Détermine si le contenu récupéré par Applebot peut servir à entraîner les modèles génératifs d’Apple. L’affichage dans les résultats de recherche reste possible. |
CCBot | Common Crawl | Archive web ouverte | Construit une archive ouverte et publiquement accessible de données web. Selon Common Crawl, consulte d’abord robots.txt. |
Dernière vérification : 17 novembre 2026. Chaque nom du tableau a été retrouvé à cette date dans la documentation du fournisseur lui-même. La liste n’est pas exhaustive : les fournisseurs décrivent aussi d’autres agents, plus spécialisés.
Sources : la documentation d’OpenAI, Anthropic, Perplexity, Google, Apple et Common Crawl, consultée le 17 novembre 2026. En cas de doute, lisez toujours la page du fournisseur lui-même : c’est elle qui fait foi.
Et Google AI Overviews et AI Mode ?
Ils font partie de la recherche Google et utilisent le Googlebot habituel. Il n’existe pas de robot distinct que vous pourriez refuser pour les AI Overviews. Google-Extended n’y change rien : ce jeton concerne l’entraînement des modèles Gemini et l’ancrage (grounding), pas les résultats de recherche.
Celui qui ne veut pas apparaître dans les fonctionnalités d’IA de la recherche Google en revient donc aux paramètres qui valent aussi pour les résultats classiques, comme les restrictions sur les extraits. Cela a immédiatement des conséquences sur la manière dont vous apparaissez dans les résultats classiques. Pour la plupart des sites d’entreprise, ce n’est pas un échange souhaitable. Plus d’informations dans Comment apparaître dans Google AI Overviews ?.
Exemple
Autoriser la recherche et refuser l’entraînement : à quoi cela ressemble-t-il ?
C’est un choix possible, pas une recommandation pour chaque site. Chaque bloc s’applique à un seul robot.
Vous pouvez donner de la même manière un bloc propre à Google-Extended et à Applebot-Extended. Attention : selon Google, Google-Extended régit aussi l’ancrage, donc l’utilisation de votre contenu comme source dans Gemini.
# Zoekcrawlers van AI-systemen: toegelaten
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Trainingscrawlers: geweigerd
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /
Si votre fichier ne contient pas de bloc pour un robot donné, celui-ci suit les règles générales sous User-agent: *. Un robot d’IA que vous ne mentionnez nulle part a donc les mêmes droits que les autres robots.
Décider
Autoriser ou bloquer les robots d’IA ?
Il n’y a pas de bonne réponse valable pour tout le monde. Cela dépend de ce que votre site doit accomplir.
Autoriser les robots de recherche s’impose quand
- vous voulez être trouvé par des personnes qui demandent conseil à un système d’IA
- votre site présente vos services ou vos produits
- vous voulez qu’un système utilise vos propres pages comme source, et pas seulement ce que d’autres écrivent sur vous
Refuser l’entraînement peut avoir du sens quand
- votre contenu est lui-même le produit, comme des articles payants ou des formations
- vous ne voulez pas, par principe, contribuer à l’entraînement de modèles
- vous avez des raisons juridiques ou contractuelles de limiter la réutilisation
Pour un site d’entreprise, bloquer les robots de recherche joue rarement en votre faveur : vous disparaissez comme source, alors que le système peut toujours parler de vous à partir d’autres sites. Ce que vous faites des robots d’entraînement est un choix qui vous appartient.
Limites
Ce que robots.txt ne peut pas faire
- Imposer quoi que ce soit. Le fichier est une demande. Les robots des fournisseurs connus affirment le respecter ; un bot malveillant ne le lit pas.
- Protéger quoi que ce soit. Ce qui ne doit pas être public doit se trouver derrière une connexion. Une règle Disallow révèle tout au plus où cela se trouve.
- Bloquer les récupérations par les utilisateurs. Plusieurs fournisseurs traitent une visite à la demande d’un utilisateur différemment d’une exploration automatique.
- Revenir en arrière. Une règle ajoutée aujourd’hui ne supprime pas le contenu déjà récupéré.
- Exclure de l’index. Disallow empêche la récupération d’une URL, pas son indexation. C’est le rôle du noindex. Voir Site ou page non indexés ?.
Celui qui veut un contrôle strict a besoin de plus que robots.txt : une gestion des accès sur le serveur, ou des règles de pare-feu basées sur les plages d’adresses IP publiées par les fournisseurs.
Contrôle
Comment vérifier ce que votre site autorise ?
Beaucoup de sites bloquent les robots d’IA sans que leur propriétaire le sache, ou autorisent tout sans que la question ait jamais été tranchée. Voici comment vérifier.
01
Ouvrez votre robots.txt
Tapez votre domaine suivi de /robots.txt. Lisez d’abord les règles générales, puis les blocs par robot.
02
Cherchez une règle trop large
La Disallow: / sous User-agent: * exclut tout le monde, y compris les moteurs de recherche. Cela arrive plus souvent qu’on ne le pense après une mise en ligne.
03
Regardez au-delà du fichier
L’hébergement, un CDN ou une extension de sécurité peuvent bloquer les bots avant qu’ils ne lisent votre robots.txt. Vérifiez aussi ces réglages.
04
Consultez vos journaux de serveur
Vous y voyez quels robots passent réellement, et quelle réponse ils reçoivent.
05
Consignez votre choix
Décidez par type de robot ce que vous voulez, et notez pourquoi. Le fichier ne reste ainsi pas un vestige accidentel.
06
Vérifiez-le régulièrement
Les fournisseurs ajoutent des robots et modifient leur comportement. Il peut aussi falloir un certain temps avant qu’une modification soit appliquée partout.
Évolution
Qu’est-ce qui va encore changer ?
Le paysage n’est pas figé. En 2026, plusieurs fournisseurs ont annoncé vouloir prendre en charge dans robots.txt un signal commun pour l’entraînement de l’IA, pour que vous n’ayez plus à répéter votre préférence robot par robot. La mise en œuvre varie selon le fournisseur, et les noms existants continuent de fonctionner.
Il existe aussi des propositions comme llms.txt, qui ne règle pas l’accès mais fournit un aperçu de votre contenu. Ce qu’il fait et ne fait pas est expliqué dans llms.txt : ce qu’il fait — et ce qu’il ne fait pas.
Robots.txt n’est d’ailleurs qu’un élément de l’explorabilité. Le rendu, les codes de statut, les canonicals et les liens internes déterminent aussi si un robot peut réellement lire votre contenu. Cet ensemble relève du SEO technique.
FAQ
Questions fréquentes sur robots.txt et les robots d’IA
Un fichier robots.txt est-il nécessaire ?
Il n’est pas obligatoire. Sans fichier, les robots partent du principe que tout peut être récupéré. Un robots.txt est toutefois utile pour exclure des parties comme un espace d’administration ou des résultats de recherche internes, et pour renvoyer vers votre sitemap.
Où trouver le fichier robots.txt de mon site ?
Toujours à la racine : votre nom de domaine suivi de /robots.txt. S’il se trouve ailleurs, les robots ne le lisent pas.
Comment modifier robots.txt dans WordPress ?
WordPress crée lui-même un fichier robots.txt virtuel s’il n’existe pas de vrai fichier. Vous pouvez le modifier avec une extension SEO qui propose un éditeur pour ce fichier, ou en plaçant votre propre fichier à la racine. Vérifiez ensuite dans le navigateur ce qui est réellement servi.
Si je bloque GPTBot, est-ce que je disparais de ChatGPT ?
Pas par cette seule règle. Selon OpenAI, GPTBot sert à l’entraînement et OAI-SearchBot à la fonction de recherche de ChatGPT, et les réglages sont indépendants l’un de l’autre. Vous pouvez donc refuser GPTBot et autoriser OAI-SearchBot.
robots.txt fonctionne-t-il encore ?
Oui, pour les robots qui le respectent, ce qui inclut notamment les robots documentés des grands moteurs de recherche et fournisseurs d’IA. Ce n’est pas un blocage technique : celui qui veut ignorer la convention le peut.
Ignorer robots.txt est-il illégal ?
Robots.txt est une convention technique, pas une loi. Les éventuelles conséquences juridiques de son non-respect dépendent du pays, des conditions d’utilisation et du droit d’auteur. C’est une question pour un juriste, pas pour un développeur.
En savoir plus sur ce sujet
Pour aller plus loin
Le service lié à ce sujet
Le service SEO technique
Vous doutez que les moteurs de recherche et les robots d’IA puissent récupérer et lire votre site ? Sur la page de service, découvrez comment j’analyse et résous les problèmes d’explorabilité, de rendu et d’indexation.

À propos de l’auteur
Dries Nijs, spécialiste Organic Web
Je suis Dries Nijs, développeur et spécialiste SEO à Maasmechelen. Je vérifie l’explorabilité dans le code, les réglages du serveur et les journaux, pas seulement dans un outil. MadeByDries est la marque personnelle sous laquelle je travaille.
Savez-vous quels robots votre site autorise ?
Parlez-moi de votre site. Nous vérifierons ensemble ce que les moteurs de recherche et les robots d’IA peuvent en lire aujourd’hui.