


Technische SEO
Technische SEO, die auch technisch gelöst wird
Ein technischer SEO-Bericht ist wenig wert, wenn die Empfehlungen danach liegen bleiben. Ich finde heraus, warum Suchmaschinen Ihre Seiten nicht richtig crawlen, rendern oder indexieren, lege fest, was zuerst geschehen muss, und passe Code, CMS oder Konfiguration selbst an. Danach teste ich erneut.
- SEO + Entwicklung
- WordPress
- React & Next.js
- Direkt mit Dries
Auf einen Blick
Was ist technische SEO?
Technische SEO (englisch: technical SEO) sorgt dafür, dass Suchmaschinen die Seiten einer Website finden, crawlen, rendern, verstehen und korrekt indexieren können. Es geht nicht darum, was auf einer Seite steht, sondern um die Voraussetzungen dafür, gelesen zu werden: die Website-Architektur, HTTP-Statuscodes, Canonicals, Weiterleitungen, Robots-Regeln, XML-Sitemaps, das Rendering von JavaScript, strukturierte Daten und Performance. Ohne diese Grundlage erreichen gute Inhalte ihr Publikum nicht: weder in Google noch in KI-Antworten.
Ich bin Entwickler und SEO-Berater und arbeite mit WordPress, React, Next.js und Node.js. Bei MadeByDries endet technische SEO nicht mit einem Bericht: Wo vereinbart, setze ich die technischen Anpassungen auch selbst um.
Wann
Wann brauchen Sie technische SEO?
Wenn Ihre Website technisch etwas tut, das Suchmaschinen behindert, oft ohne dass Sie es im Frontend sehen. Das sind typische Signale.
- Seiten werden nicht indexiert Die Search Console meldet URLs, die gefunden oder gecrawlt, aber nicht indexiert wurden.
- Platzierungen verschwinden nach einem Redesign URLs, Weiterleitungen oder Inhalte haben sich geändert, ohne dass Suchmaschinen folgen konnten.
- Google crawlt die falschen URLs Parameter, Filter oder Testumgebungen erhalten Aufmerksamkeit, die Ihre Kernseiten brauchen.
- Seiten gelten als Duplikat Dieselben Inhalte sind über mehrere URLs erreichbar, oder Canonicals verweisen falsch.
- Weiterleitungsketten und -schleifen Alte URLs leiten in mehreren Schritten weiter oder führen ins Leere.
- Langsame Seiten und schwache Core Web Vitals Der wichtigste Inhalt lädt spät, oder das Layout verspringt.
- JavaScript-Inhalte fehlen für Crawler Was ein Besucher sieht, steht nicht im HTML, das ein Crawler erhält.
- Falsche Robots- oder Noindex-Regeln Eine Einstellung aus der Testphase blockiert Seiten, die live sein sollen.
- Eine fehlerhafte Sitemap Die Sitemap enthält URLs, die weiterleiten, nicht existieren oder auf noindex stehen.
- Viele 404- und 5xx-Fehler Besucher und Crawler bleiben an Seiten oder am Server hängen.
- Fehler in strukturierten Daten oder hreflang Das Markup stimmt nicht mit der Seite überein, oder Sprachversionen verweisen nicht korrekt aufeinander.
- Shopfilter erzeugen Tausende URLs Jede Filterkombination erzeugt eine neue, nahezu identische Seite.
Der Ablauf
Von der URL zum Suchergebnis
Bevor eine Seite in den Suchergebnissen erscheint, durchläuft sie sechs Schritte. Technische SEO prüft bei jedem Schritt, ob etwas schiefläuft.
- 1
Entdecken
Google findet die URL über einen Link oder über die Sitemap.
- 2
Crawlen
Googlebot ruft die URL ab und erhält einen Statuscode zurück.
- 3
Rendern
HTML, CSS und JavaScript werden zu der Seite verarbeitet, die ein Besucher sieht.
- 4
Verstehen
Inhalte, Links, Struktur und strukturierte Daten werden interpretiert.
- 5
Indexieren
Google entscheidet, ob die Seite gespeichert wird und welche Version.
- 6
Anzeigen
Die Seite kann bei Suchanfragen erscheinen, zu denen sie passt.
Ein technisches Problem kann auf jeder dieser Ebenen die Sichtbarkeit blockieren. Die Diagnose beginnt daher mit einer Frage: An welchem Schritt hakt es?
Indexierung
Warum wird eine Seite nicht indexiert?
Eine Seite wird nicht indexiert, wenn Google sie nicht aufnehmen darf, nicht erreichen kann oder nicht für speicherwürdig hält. Die ersten beiden sind technische Ursachen und meist nachweisbar. Die dritte betrifft Inhalte und interne Priorität.
- Noindex Ein Meta-Tag oder Header fordert ausdrücklich, die Seite nicht aufzunehmen.
- Robots.txt Der Crawler darf die URL nicht abrufen und sieht den Inhalt daher nicht.
- Falscher Canonical Die Seite gibt eine andere URL als bevorzugte Version an.
- Doppelte Inhalte Google wählt eine andere URL mit denselben Inhalten.
- Soft 404 Die Seite liefert Status 200, wirkt aber leer oder wie eine Fehlerseite.
- Weiterleitung Die URL leitet weiter: Bewertet wird das Ziel, nicht die URL selbst.
- Serverprobleme Timeouts oder 5xx-Fehler beim Crawlen.
- JavaScript-Rendering Der Inhalt erscheint erst nach Skripten, die der Crawler nicht oder zu spät ausführt.
- Schwache interne Verlinkung Wenige oder keine Links zur Seite, wodurch sie unwichtig wirkt.
- Sitemap-Fehler Die URL fehlt in der Sitemap oder steht dort in einer anderen Form.
- Wenig eigener Mehrwert Inhalte, die sich kaum von anderen Seiten unterscheiden.
Welche Ursache vorliegt, lese ich aus der Search Console, dem rohen HTML und den Serverantworten ab, nicht aus einer Vermutung. Jede Ursache einzeln erklärt finden Sie unter Website oder Seite nicht indexiert?
Canonicals
Canonicals: Welche URL ist die echte Version?
Ein Canonical gibt an, welche URL Sie als bevorzugte Version meinen, wenn dieselben oder nahezu dieselben Inhalte über mehrere URLs erreichbar sind. Google behandelt den Canonical als starkes Signal, nicht als Anweisung: Widersprechen interne Links, Weiterleitungen oder die Sitemap, kann Google eine andere URL wählen. So steht es auch in Googles Dokumentation zu kanonischen URLs.
Deshalb prüfe ich nicht nur den Tag, sondern ob alle Signale auf dieselbe URL verweisen. Doppelte Versionen entstehen meist an diesen Stellen. Mehr dazu unter Canonical-Tag einfach erklärt.
- Parameter
- Filter
- Sortierung
- Produktvarianten
- Tracking-Parameter
- Mit und ohne www
- HTTP und HTTPS
- Paginierung
- Sprach- und Länderversionen
Statuscodes
Statuscodes und Weiterleitungen: was Ihr Server antwortet
Jede Anfrage erhält einen Statuscode zurück. Er sagt einem Crawler, ob die Seite existiert, umgezogen ist oder fehlt.
Die Wirkung liegt selten in einem einzelnen Code, sondern in Mustern: interne Links, die auf Weiterleitungen zeigen, Weiterleitungsketten mit drei oder vier Schritten, Schleifen und Statuscodes, die nicht sagen, was wirklich los ist. Bei einer Migration entscheiden diese Muster, ob Ihre Sichtbarkeit mit umzieht. Die Begleitung dabei finden Sie auf der Seite Website-Migration.
| Code | Bedeutung und worauf zu achten ist |
|---|---|
| 200 | Die Seite existiert und wird ausgeliefert. Achten Sie auf Seiten, die 200 liefern, aber eigentlich leer sind oder einen Fehler zeigen. |
| 301 | Permanente Weiterleitung. Die richtige Wahl, wenn eine URL endgültig umzieht. |
| 302 | Temporäre Weiterleitung. Oft versehentlich verwendet, wo eine 301 gemeint ist. |
| 404 | Die Seite existiert nicht. Normal bei gelöschten Inhalten, ein Problem, wenn interne Links darauf verweisen. |
| 410 | Bewusst und endgültig entfernt. |
| 5xx | Der Server kann die Anfrage nicht verarbeiten. Bei Wiederholung crawlt Google langsamer. |
Robots und Sitemaps
Robots.txt, noindex und XML-Sitemap haben jeweils eine andere Funktion
Drei Instrumente, die oft verwechselt werden, mit Fehlern als Folge.
Steuert das Crawlen
robots.txt
Legt fest, welche URLs ein Crawler abrufen darf. Eine blockierte URL kann trotzdem im Index stehen, wenn Links auf sie verweisen.
Steuert die Indexierung
noindex
Fordert, eine Seite nicht aufzunehmen. Der Crawler muss die Seite aber abrufen können, um diese Anweisung zu sehen.
Hilft beim Entdecken
XML-Sitemap
Eine Liste der URLs, die Sie indexiert sehen möchten. Sie garantiert nichts, zeigt aber, was Ihnen wichtig ist.
Wer eine bestehende URL aus Google entfernen möchte, nutzt also noindex oder löscht die Seite und blockiert sie nicht in der robots.txt: Sonst kann Google das noindex nicht mehr lesen.
JavaScript-SEO
JavaScript-SEO: sichtbar für Nutzer und Crawler
JavaScript-Websites erfordern besondere Aufmerksamkeit für Rendering, Crawlbarkeit und das HTML, das ein Crawler tatsächlich erhält. Google kann JavaScript ausführen, tut das aber in einem separaten Schritt und nicht immer sofort: siehe Googles Leitfaden zu den Grundlagen der JavaScript-SEO. Andere Crawler, darunter die von KI-Systemen, führen Skripte oft überhaupt nicht aus.
Clientseitiges Rendering
Der Browser baut die Seite mit JavaScript auf. Das erste HTML ist fast leer: Wer keine Skripte ausführt, sieht nichts.
Serverseitiges Rendering
Der Server sendet pro Anfrage vollständiges HTML. Inhalte, Links und Metadaten sind sofort lesbar.
Statische Generierung
Das HTML wird vorab erzeugt. Schnell und vollständig lesbar, geeignet für Inhalte, die sich nicht je nach Besucher unterscheiden.
Deshalb ist serverseitiges Rendering oder Prerendering für Seiten, die gefunden werden sollen, oft sinnvoll. In React und Next.js lege ich pro Route fest, welche Form passt, und prüfe, was tatsächlich im ersten HTML steht. Das sind die Punkte, an denen es oft schiefläuft.
- Hydration
- Verzögert geladene Inhalte
- Links ohne href
- Metadaten pro Route
- Canonicals
- Statuscodes bei clientseitigen Routen
WordPress
Technische SEO in WordPress
WordPress ist eine solide Grundlage für SEO. Die technischen Probleme entstehen meist durch das, was darauf aufgesetzt wird: Themes, Pagebuilder und Plugins, die jeweils eigene Entscheidungen treffen.
Ich entwickle selbst WordPress-Websites und kenne beide Seiten: was ein Plugin gut einstellt und was Sie besser im Theme oder mit einem Hook lösen.
- Plugin-Konflikte
- Ausgabe von Pagebuildern
- Doppelte Archive
- Schlagwörter und Kategorien
- Anhangseiten
- URL-Parameter
- Canonical-Einstellungen
- Fehlerhafte Sitemaps
- Caching
- Schwere Skripte
- Bilder
- Weiterleitungen
- Schema aus mehreren Plugins
Performance
Performance, die Sie messen können
Google misst das Nutzererlebnis mit drei Core Web Vitals, auf Basis echter Besuche. Die Definitionen finden Sie auf web.dev.
LCP
Largest Contentful Paint
Wie schnell der wichtigste Inhalt der Seite sichtbar ist.
INP
Interaction to Next Paint
Wie schnell die Seite reagiert, wenn jemand klickt, tippt oder schreibt.
CLS
Cumulative Layout Shift
Wie stabil das Layout bleibt, während die Seite lädt.
Ein Lighthouse-Score von 100 ist keine Garantie für Top-Platzierungen: Lighthouse ist ein Labortest auf einem einzigen Gerät. Performance ist ein Teil von Nutzererlebnis, technischer Qualität und SEO. Ich verbessere sie dort, wo Besucher und Messungen tatsächlich darunter leiden: Bilder, Skripte, Schriften, Serverzeit und Caching. Mehr dazu unter Core Web Vitals erklärt.
Strukturierte Daten
Strukturierte Daten: Kontext hinzufügen, kein Ranking-Hack
Strukturierte Daten beschreiben in einer festen, maschinenlesbaren Form, was auf einer Seite steht: wer der Autor ist, welche Leistung angeboten wird und wo die Seite in der Website einzuordnen ist. Das ist Kontext, kein Ranking-Hack. Das Markup muss mit dem übereinstimmen, was ein Besucher auf der Seite sieht.
Für GEO (Generative Engine Optimization) gilt dasselbe: Maschinen verstehen die Beziehungen zwischen Entitäten besser, wenn Website und Markup dasselbe aussagen. Mehr dazu unter Strukturierte Daten und Schema-Markup.
- Person
- Organization
- Service
- Product
- Article
- BreadcrumbList
Was ich nicht tue
- erfundene Bewertungen oder Rezensionen auszeichnen
- ein Offer ohne echten Preis oder echtes Angebot hinzufügen
- Schema nur einsetzen, um ein Rich Result zu erzwingen
- FAQ-Markup verwenden, wo die Fragen nicht auf der Seite stehen
Struktur
Technik steckt auch in der Struktur
Wie Seiten miteinander verknüpft sind, bestimmt, was ein Crawler findet und wie wichtig er es einschätzt.
Diese Struktur lege ich vor dem Design fest, wenn Sie planen, eine neue Website erstellen zu lassen.
- Logische URLs Lesbar, stabil und ohne überflüssige Parameter.
- Klicktiefe Wichtige Seiten liegen wenige Klicks von der Startseite entfernt.
- Verwaiste Seiten Seiten ohne interne Links werden selten gefunden.
- Interne Links Normale Links mit einem href und einem Ankertext, der sagt, wohin sie führen.
- Taxonomie Kategorien und Schlagwörter, die sich nicht überschneiden.
- Paginierung Folgeseiten, die erreichbar bleiben, wo das nötig ist.
- Facettennavigation Filter, die keine endlose Reihe von URLs erzeugen.
- Eine Hauptintention pro URL Damit Seiten nicht miteinander konkurrieren.
Komplexere Websites
Mehrsprachige Websites und Onlineshops: wo die Technik am stärksten ins Gewicht fällt
Abgrenzung
Was ist der Unterschied zwischen einem SEO-Audit und technischer SEO?
Ein SEO-Audit erfasst Probleme und Prioritäten. Technische SEO ist die umfassendere Arbeit, mit der diese technische Grundlage untersucht, verbessert und kontrolliert wird. Bei MadeByDries können Analyse und Umsetzung im selben Projekt nahtlos ineinandergreifen.
Ein Audit ist also die Diagnose. Technische SEO umfasst auch die Behebung und die anschließende Kontrolle. Was die Diagnose umfasst, lesen Sie unter SEO-Audit.
Analyse und Umsetzung
Kein SEO-Bericht, der in der Schublade landet
Ein Crawler oder SEO-Tool kann Dutzende oder Hunderte Warnungen ausgeben. Nicht jede Warnung hat dieselbe Wirkung, und manche haben gar keine. Die Arbeit beginnt also nicht bei der Liste, sondern bei der Frage, was tatsächlich passiert.
Ich messe, prüfe, was tatsächlich passiert, bestimme die Wirkung, lege die Reihenfolge fest, setze die Anpassungen um, wo wir das vereinbaren, und teste erneut. Das sind Beispiele dafür, was ich dann anpasse.
- Templates
- Metadaten-Logik
- Canonical-Logik
- Weiterleitungen
- Sitemap-Filter
- Strukturierte Daten
- Rendering
- Performance
- Komponenten für interne Links
- WordPress-Hooks
- Metadaten und Rendering in Next.js
Prioritäten
Nicht jeder technische SEO-Fehler ist gleich wichtig
Ich ordne Befunde in drei Stufen ein. Nicht auf Basis eines Tool-Scores, sondern danach, was sie in Ihrer Situation blockieren.
Stufe 1
Blockierend
Sichtbarkeit ist unmöglich, bis das behoben ist.
- wichtige Seiten nicht indexierbar
- ein fehlerhaftes noindex
- fehlschlagendes Rendering
- Serverprobleme
- ein falscher Canonical auf Kernseiten
Stufe 2
Hohe Wirkung
Sichtbarkeit geht verloren oder wird aufgeteilt.
- Weiterleitungsketten
- doppelte URLs
- eine schwache Architektur
- Crawl-Verschwendung durch Filter
- gravierende Performance-Probleme
Stufe 3
Optimierung
Sinnvoll, aber nicht dringend.
- kleinere Verbesserungen im Markup
- Metadaten bereinigen
- nicht kritische Warnungen
Dieselbe Meldung kann auf der einen Website blockierend und auf der anderen nebensächlich sein. Diese Einschätzung trifft ein Spezialist im Kontext, kein Score.
GEO
Technische SEO ist auch die Grundlage für GEO
KI-Systeme müssen Ihre Inhalte erreichen, lesen, verstehen und den richtigen Entitäten zuordnen können, genau wie eine Suchmaschine. Semantisches HTML, wo nötig serverseitig gerenderte Inhalte, strukturierte Daten, korrekte Canonicals, Crawlbarkeit und eine klare Architektur bilden dafür dieselbe Grundlage.
Was für Sichtbarkeit in KI-Antworten noch hinzukommt, erfahren Sie unter GEO & KI-SEO.
Welche Ursache vorliegt, lese ich aus der Search Console, dem rohen HTML und den Serverantworten ab, nicht aus einer Vermutung.
Projekte
Projekte, bei denen die Technik Teil der Entwicklung ist
Zwei eigene Plattformen mit React, die ich selbst entwickle. In den Fallstudien lesen Sie, wie Rendering, Sprachversionen und strukturierte Daten aufgebaut sind.
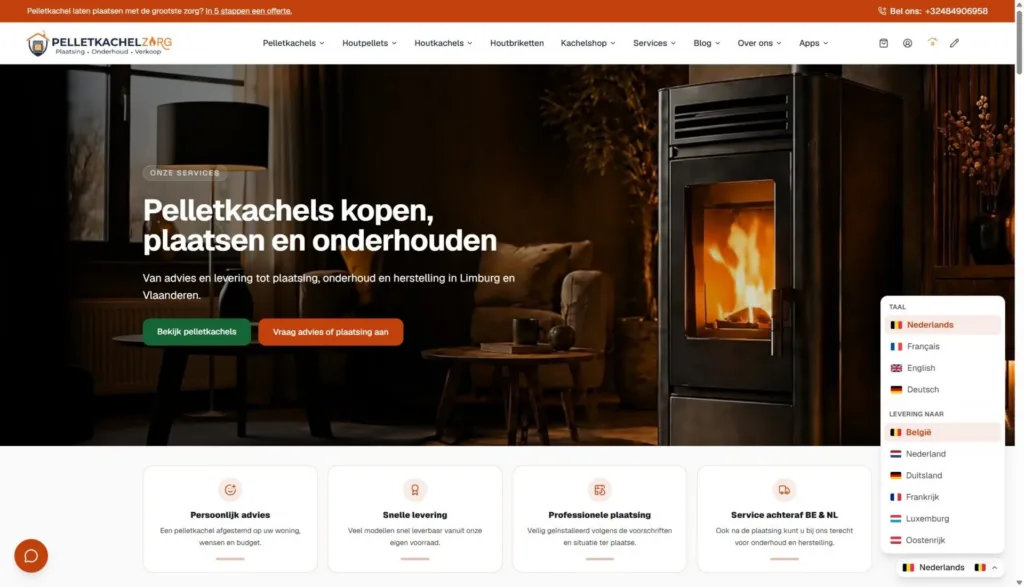
React & Next.js · E-Commerce · Organic Web
Pelletkachelzorg
Meine eigene Commerce-Plattform mit React und Next.js für Verkauf, Installation und Wartung von Öfen, in vier Sprachen.
- React
- Next.js
- Claude
- GPT
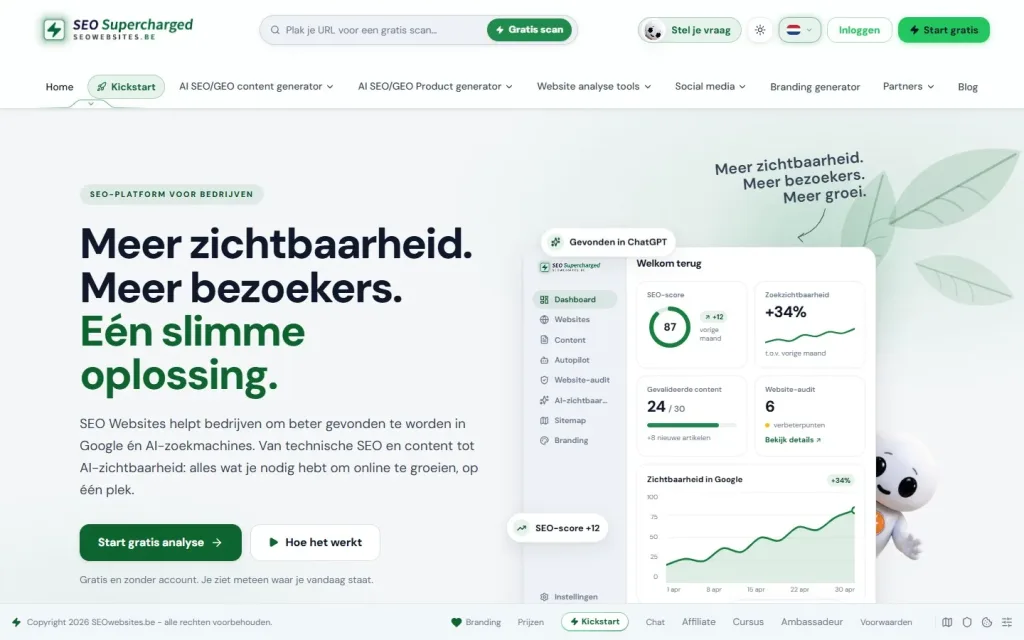
SEO · GEO · Organic Web
SEO Websites
Meine eigene SaaS-Plattform für Website-Analyse, SEO-Content und Auffindbarkeit in Suchmaschinen und KI-Systemen.
- React
- Node.js
- Express
- Claude
Arbeitsweise
Vom technischen Problem zur kontrollierten Lösung
Als abgegrenzter Auftrag oder als Teil eines umfassenderen SEO-Projekts. Eine feste Durchlaufzeit verspreche ich nicht: Sie hängt vom Problem ab und davon, wie schnell Suchmaschinen Änderungen verarbeiten.
01
Diagnose
Was passiert tatsächlich? Search Console, rohes HTML, gerenderte Seite und Serverantworten im direkten Vergleich.
02
Wirkung
Was betrifft Crawlbarkeit, Indexierung oder Performance, und wie stark?
03
Priorität
Was zuerst kommen muss, was warten kann und was nicht nötig ist.
04
Umsetzung
Anpassungen an Code, CMS oder Konfiguration, wo vereinbart durch mich.
05
Validierung
Erneut crawlen, testen und prüfen, ob die Änderung tut, was sie soll.
06
Monitoring
Verfolgen, ob Suchmaschinen die Änderung verarbeiten.
Womit ich messe
Serverlogs nutze ich, wenn sie verfügbar und relevant sind.
- Google Search Console
- Lighthouse und PageSpeed Insights
- Browser-DevTools
- Crawler
- DataForSEO
- Schema-Validatoren
Preis
Was kostet technische SEO?
Der Preis für technische SEO hängt vom Ausmaß des Problems und vom Aufwand für die Lösung ab. Nach einer ersten Analyse kann ich Umfang und Preis konkret festlegen. Das ist als einmaliger Auftrag möglich: Ein verpflichtendes Monatsmodell gibt es nicht.
- Umfang der Website Die Anzahl der Seiten und URLs, die berücksichtigt werden.
- Plattform WordPress, ein Onlineshop, React oder Next.js oder eine Individualentwicklung.
- Anzahl der Templates Ein Fehler in einem Template betrifft alle Seiten, die es verwenden.
- Art des Problems Eine Einstellung anzupassen ist etwas anderes, als das Rendering neu aufzubauen.
- Technische Schulden Was im Laufe der Jahre liegen geblieben ist.
- Analyse oder Umsetzung Nur die Diagnose oder auch die Umsetzung.
- Komplexität des Onlineshops Filter, Varianten und Produktanzahl.
- Migration Ein Umzug erfordert zusätzliche Vorbereitung und Kontrolle.
- Individueller Code Wie viel in bestehendem Code angepasst werden muss.
Warum Dries
Technische SEO von jemandem, der auch entwickelt
- Direkt mit Dries Sie sprechen mit der Person, die das Problem untersucht und löst.
- Entwickler und SEO-Berater WordPress, React, Next.js und Node.js: Ich lese den Code, in dem das Problem steckt.
- Analyse und Umsetzung Die Empfehlungen bleiben nicht bei einem Dritten liegen.
- Mit Blick auf GEO Was ich technisch in Ordnung bringe, hilft auch KI-Systemen, Ihre Inhalte zu lesen.

Über den Spezialisten
Dries Nijs, Organic Web Specialist
Ich bin Dries Nijs, Organic Web Specialist und Spezialist für technische SEO aus Maasmechelen. Seit den 90er-Jahren entwickle ich Websites, heute mit WordPress, React, Next.js und Node.js. Diesen Entwicklungshintergrund nutze ich, um technische SEO-Probleme nicht nur zu finden, sondern auch zu lösen. MadeByDries ist die persönliche Marke, unter der ich arbeite.
FAQ
Häufige Fragen zu technischer SEO
Was gehört zur technischen SEO?
Alles, was bestimmt, ob Suchmaschinen eine Website finden, crawlen, rendern und indexieren können: Website-Architektur, interne Links, Statuscodes und Weiterleitungen, Canonicals, Robots-Regeln, XML-Sitemaps, JavaScript-Rendering, strukturierte Daten, hreflang und Performance. Die Texte selbst und Links von anderen Websites gehören nicht dazu.
Was ist der Unterschied zwischen technischer SEO und normaler SEO?
Technische SEO ist ein Teil von SEO. SEO umfasst auch die Inhalte (beantwortet eine Seite die Suchanfrage?) und die Autorität (verweisen andere Websites auf Sie?). Technische SEO sorgt dafür, dass Inhalte und Autorität ihre Wirkung entfalten können. Die umfassendere Arbeit übernehme ich ebenfalls, als SEO-Berater.
Warum wird meine Website von Google nicht gefunden?
Meist aus einem von drei Gründen: Google kann die Seiten nicht erreichen, darf sie nicht aufnehmen oder hält sie für nicht ausreichend eigenständig. Die ersten beiden sind technisch: ein noindex, eine Sperre in der robots.txt, ein falscher Canonical, Serverfehler oder Inhalte, die nur über JavaScript erscheinen. In der Search Console steht pro URL, welchen Grund Google angibt.
Wie lange dauert es, bis Google eine Seite indexiert?
Das reicht von einigen Tagen bis zu einigen Wochen, manchmal geht es schneller, und Google garantiert nicht, dass eine Seite aufgenommen wird. Es hängt davon ab, wie oft Ihre Website gecrawlt wird, wie die Seite intern verlinkt ist und wie wertvoll Google sie einschätzt. Ein Antrag über die Search Console kann es beschleunigen, aber nicht erzwingen.
Ist die Ladegeschwindigkeit einer Website wichtig für SEO?
Ja, als ein Faktor unter vielen. Google nutzt die Core Web Vitals als Signal für das Nutzererlebnis, relevante Inhalte wiegen aber schwerer. Geschwindigkeit zählt vor allem für Ihre Besucher: Eine langsame Seite verliert sie, bevor sie etwas gelesen haben. Ein perfekter Lighthouse-Score ist kein Selbstzweck.
Was ist ein Canonical-Tag?
Ein Canonical-Tag ist eine Zeile im HTML einer Seite, die angibt, welche URL die bevorzugte Version ist, wenn dieselben Inhalte über mehrere URLs erreichbar sind. Suchmaschinen nutzen ihn als starkes Signal, um doppelte URLs zusammenzuführen, sind aber nicht verpflichtet, ihm zu folgen.
Ist JavaScript schlecht für SEO?
Nein. JavaScript-Websites erfordern aber besondere Aufmerksamkeit für das Rendering und für das HTML, das ein Crawler erhält. Mit serverseitigem Rendering oder statischer Generierung, wie in Next.js, steht der Inhalt sofort im HTML. Probleme entstehen, wenn Inhalte, Links oder Metadaten erst existieren, nachdem Skripte ausgeführt wurden.
Woran erkenne ich, ob Google meine Website crawlen kann?
Mit der URL-Prüfung in der Google Search Console sehen Sie pro Seite, ob Google sie abrufen konnte, wie sie gerendert wurde und ob sie indexiert ist. Der Bericht zur Seitenindexierung zeigt das für die gesamte Website. Prüfen Sie außerdem die robots.txt, die Statuscodes und das, was im rohen HTML steht.
Steckt ein technisches Problem in Ihrer Website?
Erzählen Sie mir, was Sie in der Search Console oder auf Ihrer Website sehen. Ich sage Ihnen, was ich untersuchen und was ich selbst lösen kann.