


IA & automatisation
IA et données d’entreprise : API, RAG et confidentialité expliqués
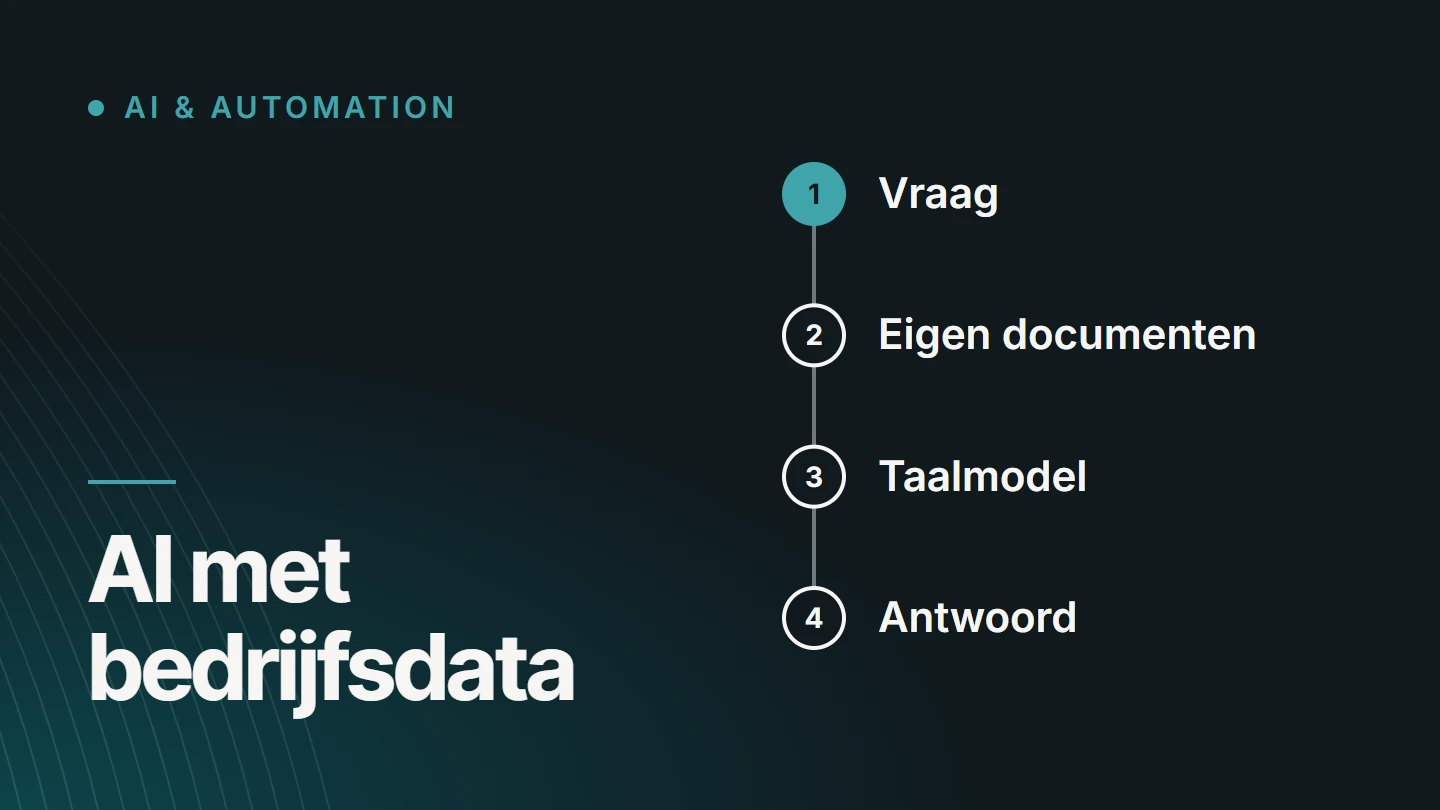
L’IA avec des données d’entreprise signifie qu’un modèle de langage répond sur la base de vos propres documents et données, que votre logiciel recherche à chaque question et transmet via une API. Le modèle lui-même ne connaît pas votre entreprise : il a été entraîné sur des textes généraux et ne sait rien de vos clients, de vos prix ou de vos procédures. La technique qui consiste à rechercher d’abord, puis à faire répondre, s’appelle RAG, retrieval-augmented generation.
Par Dries Nijs, spécialiste Organic Web
Dernière mise à jour : 19 novembre 2026
En bref
Comment fonctionne l’IA avec des données d’entreprise ? La réponse courte
Pour obtenir une réponse utile sur votre entreprise, deux types de connaissances sont nécessaires. Les connaissances du modèle sont ce que le modèle de langage a appris pendant son entraînement : la langue, des faits généraux, le raisonnement. Les connaissances de l’entreprise sont ce qui se trouve uniquement dans vos systèmes. Ce second type ne se trouve pas dans le modèle, et n’a pas besoin d’y être.
Au lieu de réentraîner le modèle, vous lui donnez la bonne information au bon moment. Votre logiciel recherche les passages liés à la question, les transmet et demande au modèle de s’appuyer uniquement sur eux. Vos documents restent là où ils sont ; seul ce qui est nécessaire pour cette question précise est envoyé au modèle.
Trois éléments deviennent ainsi plus importants que le modèle lui-même : la qualité de vos documents, les droits d’accès lors de la recherche et les accords avec le fournisseur sur ce qu’il advient des données transmises.
Comparaison
Connaissances du modèle et connaissances de l’entreprise : quelle différence ?
Un modèle de langage donne l’impression de tout savoir. Pourtant, ce qu’il dit provient de deux sources clairement distinctes.
| Critère | Connaissances du modèle | Connaissances de l’entreprise |
|---|---|---|
| Origine | Les textes sur lesquels le modèle a été entraîné | Vos propres documents, bases de données et systèmes |
| Contenu | La langue, les connaissances générales, le raisonnement | Produits, prix, clients, procédures, accords |
| Actualité | S’arrête au moment où l’entraînement a pris fin | Aussi à jour que vos propres sources |
| Mise à jour | Seulement avec une nouvelle version du modèle | Vous modifiez le document et la réponse change avec lui |
| Citer la source | Impossible | La réponse peut renvoyer au document source |
| Accès | Identique pour tous ceux qui utilisent le modèle | Selon la personne qui pose la question |
Si un modèle reçoit une question sur votre entreprise sans avoir reçu de connaissances sur celle-ci, il comble le vide avec quelque chose qui semble plausible. Une telle réponse inventée s’appelle une hallucination. La solution n’est pas un modèle plus intelligent, mais la bonne information jointe à la question.
Connexion
L’API : comment votre logiciel communique avec le modèle
Votre logiciel communique avec un modèle de langage via une API : il envoie une requête contenant une instruction et le texte nécessaire, et reçoit une réponse en retour. Tout ce que le modèle peut utiliser pour cette réponse se trouve dans cette seule requête.
Deux propriétés déterminent la manière de traiter les données d’entreprise. Le modèle ne retient rien lui-même entre deux appels : ce que vous avez envoyé la fois précédente a disparu. Et la quantité de texte par appel est limitée : impossible donc d’envoyer l’intégralité de vos archives. Plus de texte ne rend d’ailleurs pas automatiquement la réponse meilleure.
D’où la question centrale de ce sujet : quels éléments d’information envoyer avec quelle question ? La réponse s’appelle retrieval, la recherche des bons passages. La place d’une telle connexion dans un logiciel existant est expliquée dans Intégrations d’IA : connecter l’IA aux systèmes existants.
Technique
Comment fonctionne le RAG (retrieval-augmented generation) ?
RAG signifie retrieval-augmented generation : d’abord rechercher (retrieval), puis faire répondre le modèle (generation) en complétant sa demande avec le texte trouvé (augmented). En six étapes :
01
Préparer les documents
Vos sources sont découpées en morceaux plus petits, comme un paragraphe ou un chapitre, pour permettre ensuite une recherche ciblée.
02
Indexer
Pour chaque morceau, on calcule un embedding : une série de nombres qui représente le sens du texte. Ces séries sont conservées dans un index, souvent une base de données vectorielle.
03
Rechercher
Une question est convertie de la même manière et comparée à l’index. Les morceaux dont le sens est le plus proche de la question arrivent en tête, même s’ils utilisent d’autres mots. Cette recherche est souvent combinée avec une recherche par mots-clés.
04
Compléter
Les morceaux trouvés sont envoyés au modèle avec la question et une instruction : réponds uniquement sur la base de ce texte, et dis-le si la réponse n’y figure pas.
05
Répondre
Le modèle formule une réponse à partir des passages fournis. Il ne recherche rien lui-même : il lit ce que l’étape de recherche lui a fourni.
06
Renvoyer vers la source
La réponse indique de quel document elle provient, pour qu’un collaborateur puisse la vérifier.
Sources
Quels documents et quelles données conviennent ?
Une réponse issue du RAG n’est jamais meilleure que la source dont elle provient. Ce qui est erroné, obsolète ou contradictoire dans vos documents se retrouve tel quel dans la réponse.
Bien exploitables
- manuels, procédures et instructions de travail
- informations produits et fiches techniques
- questions fréquentes avec une réponse vérifiée
- conditions et textes de politique dans leur version actuelle
- documents avec un titre, une date et un responsable clairement identifiés
À mettre d’abord en ordre
- anciennes versions qui coexistent avec la version actuelle
- documents qui se contredisent
- scans et images sans texte lisible
- connaissances qui n’existent que dans les têtes ou les boîtes mail
- fichiers dont personne ne sait s’ils sont encore exacts
Les données structurées, comme les commandes, le stock ou les fiches clients, se consultent mieux directement dans la base de données que via des passages de texte. Une bonne solution combine souvent les deux : des passages de documents pour les explications, une requête ciblée pour les chiffres et les statuts. Si le modèle peut choisir et exécuter lui-même ces requêtes, on parle d’un agent : voir Agents IA pour les entreprises : 7 processus à automatiser.
Accords
Droits d’accès, confidentialité et sécurité
Dès qu’un modèle travaille avec des données d’entreprise, il ne s’agit plus seulement de la qualité de la réponse, mais aussi de qui voit quoi et de l’endroit où les données aboutissent.
- Des droits lors de la recherche L’étape de recherche ne renvoie que les documents que la personne qui pose la question est elle-même autorisée à consulter. Ce contrôle a lieu dans votre logiciel, avant que quoi que ce soit ne soit envoyé au modèle, et non par le modèle.
- Transmettre le moins possible Seuls les passages nécessaires à la question sont transmis. Ce qui n’est pas nécessaire, comme des noms ou des coordonnées, est omis ou anonymisé.
- Ce qui quitte vos systèmes Identifiez les données envoyées au fournisseur du modèle, et vérifiez si elles contiennent des données personnelles ou des informations confidentielles.
- Où elles sont traitées Vérifiez dans quelle région les données sont traitées et combien de temps le fournisseur les conserve.
- Utilisation pour l’entraînement Lisez dans les conditions du fournisseur si les données transmises sont utilisées pour entraîner des modèles, et si vous pouvez l’exclure.
- Clés et index La clé de l’API reste sur le serveur. L’index contient lui aussi vos informations d’entreprise et mérite la même sécurité que les documents eux-mêmes.
Si les documents contiennent des données personnelles, le RGPD est le cadre dans lequel vous évaluez tout cela. Ceci n’est pas un avis juridique : faites examiner votre situation concrète par une personne qui connaît le droit de la protection des données.
Limites
Pourquoi ne pas mettre vos données d’entreprise n’importe comment dans un modèle
Coller dans un service de chat public
Coller un contrat ou une liste de clients dans un service de chat public revient à envoyer ces données à un tiers sans que votre entreprise ait conclu d’accord à ce sujet. Définissez donc en interne quelles données peuvent aller dans quels outils, et prévoyez une alternative couverte par vos propres accords.
Entraîner un modèle sur vos propres données
Réentraîner un modèle, ce qu’on appelle aussi le fine-tuning, adapte surtout son style ou son comportement. Il convient moins comme réservoir de connaissances : vous ne pouvez pas en retirer ou y mettre à jour un fait de manière ciblée, le modèle ne peut pas indiquer d’où vient une réponse, et il ne fait aucune distinction selon la personne qui pose la question. Pour des connaissances qui évoluent ou qui ne sont pas destinées à tout le monde, la recherche au moment de la question est la voie la plus logique.
Le contrôle humain reste nécessaire
Même avec les bons passages, un modèle peut mal lire quelque chose ou combiner deux sources de manière erronée. Faites vérifier, approuver ou corriger les réponses par une personne là où une erreur a des conséquences, et affichez toujours la source. Ma manière d’aborder l’automatisation et les connexions IA pour les entreprises est présentée sur la page automatisation par l’IA.
FAQ
Questions fréquentes sur l’IA et les données d’entreprise
Qu’est-ce que le RAG, en termes simples ?
Le RAG, c’est un examen à livre ouvert pour un modèle de langage. Au lieu de répondre de mémoire, le modèle reçoit à chaque question les passages correspondants de vos propres documents, et formule une réponse à partir de ceux-ci. L’abréviation signifie retrieval-augmented generation.
Dois-je entraîner un modèle sur mes propres données ?
Pour des connaissances, généralement pas. La recherche au moment de la question garde vos informations à jour, respecte les droits d’accès et permet d’afficher la source. Le réentraînement convient plutôt à un style fixe ou à une tâche très spécifique.
Un modèle de langage connaît-il mon entreprise ?
Tout au plus ce qui était publiquement accessible au moment de son entraînement, et même cela est incomplet et dépassé. Il ne connaît ni vos documents internes, ni vos prix, ni vos clients, ni vos accords, sauf si vous les transmettez avec la question.
L’IA avec des données d’entreprise peut-elle encore se tromper ?
Oui. Le RAG réduit le risque que le modèle invente quelque chose, puisque la réponse s’appuie sur du texte fourni, mais il n’exclut pas les erreurs. L’étape de recherche peut trouver le mauvais passage, ou le modèle peut mal lire un passage. Une mention de la source et une personne qui relit là où c’est important restent nécessaires.
Le RAG est-il sûr pour des documents confidentiels ?
Cela dépend de la configuration. Les éléments déterminants sont les droits d’accès lors de la recherche, l’endroit où se trouvent l’index et les documents, et les conditions du fournisseur du modèle. Pour des données très sensibles, un modèle hébergé sur votre propre infrastructure peut être une option.
Ai-je besoin d’une base de données vectorielle ?
Pas toujours. Pour un ensemble limité de documents, une fonction de recherche classique ou une extension de votre base de données existante peut suffire. Une base de données vectorielle distincte devient pertinente pour de grands volumes de texte ou lorsque la recherche par le sens donne des résultats nettement meilleurs.
L’IA avec des données d’entreprise est-elle accessible à une PME ?
La technique n’est pas réservée aux grandes entreprises. Ce qui détermine le travail, c’est l’état de vos documents, le nombre de sources et les exigences en matière d’accès. Un démarrage bien délimité, comme un seul ensemble de manuels pour une seule équipe, garde le projet lisible. Pour le sur mesure, le prix est communiqué sur demande.
En savoir plus sur ce sujet
Pour aller plus loin
Le service lié à ce sujet
Le service d’automatisation par l’IA
Vous voulez faire travailler un modèle de langage avec vos propres documents ou systèmes ? La page de service explique comment j’aborde l’automatisation et les connexions IA, avec une attention particulière aux données, aux droits et au contrôle.

À propos de l’auteur
Dries Nijs, spécialiste Organic Web
Je suis Dries Nijs, développeur à Maasmechelen. Je crée pour le web depuis les années 90 : des applications web avec React, Next.js et Node.js, et des sites WordPress. Dans mes propres plateformes, comme BM Jumpfun, Pelletkachelzorg et SEO Websites, j’utilise l’IA via des API. MadeByDries est la marque personnelle sous laquelle je travaille.
Faire travailler l’IA avec vos propres données ?
Dites-moi à quelles questions le système doit répondre et où se trouvent aujourd’hui les informations. Nous verrons ensemble ce qui est faisable et responsable.